Alibaba abre Qwen4-Max-Preview con un millón de tokens de contexto y una prueba hasta el 25 de noviembre
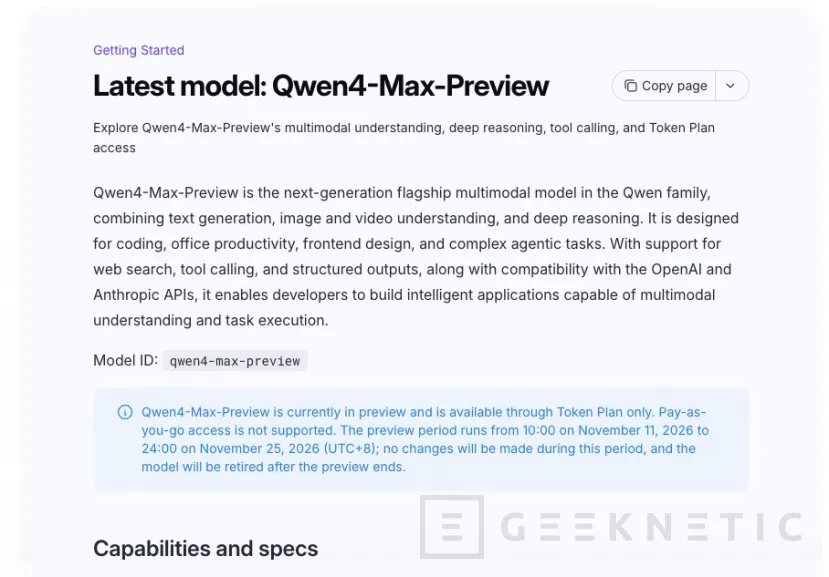
por Manuel NaranjoAlibaba ha abierto el acceso preliminar a Qwen4-Max-Preview, su nueva generación de modelos multimodales para programación, razonamiento y tareas con herramientas. La documentación de QwenCloud confirma un contexto de un millón de tokens y capacidad para analizar imágenes y vídeo.
La prueba comenzó hoy 11 de noviembre a las 03:00, hora peninsular española. El acceso se realiza mediante API y exige contratar Token Plan; esta versión no admite pago por consumo independiente.
El máximo de salida es de 393.216 tokens, incluidos los empleados en razonar. Por tanto, esa cifra no corresponde íntegramente al texto que recibe el usuario: el razonamiento consume parte del presupuesto disponible para la respuesta.
Acceso mediante Token Plan y límites de uso
Token Plan Individual funciona con una suscripción y un saldo de créditos del que se descuenta el consumo. La documentación enumera planes Lite, Essential, Standard y Pro, con cuotas mensuales diferentes. Las llamadas y las herramientas comparten ese saldo, de modo que contratar un plan no equivale a disponer de solicitudes ilimitadas.
Hay una condición que afecta al tipo de integración permitido. La modalidad Individual se limita al uso interactivo en herramientas de programación y agentes. Excluye los scripts de automatización, los servidores de aplicaciones propias y las llamadas no interactivas por lotes. Quien quiera probarlo debe revisar esas condiciones antes de trasladar una integración existente.
La guía también sitúa Token Plan en la región de Singapur, con despliegue global. Esto implica que las solicitudes y respuestas pueden transferirse entre países. Es una característica del servicio contratado que conviene considerar cuando se trabaja con documentación empresarial.
Razonamiento regulable y continuidad entre turnos
La guía de razonamiento identifica Qwen4-Max-Preview como un modelo híbrido, con el razonamiento activado por defecto. Ese modo permite realizar un procesamiento previo a la respuesta; su coste en tokens forma parte de la salida, algo especialmente relevante al configurar límites pequeños.
El desarrollador puede regular la intensidad del razonamiento o fijar un presupuesto específico. La documentación advierte de que ambos controles no pueden configurarse simultáneamente para este modelo: hay que escoger uno de los dos métodos.
En las conversaciones de varios turnos también cambia la gestión del historial. Qwen4-Max-Preview conserva el razonamiento por defecto y la guía pide devolver ese contenido en su campo específico, separado de la respuesta visible. Una integración que reconstruya el historial únicamente con el texto final necesita tener en cuenta ese comportamiento.
Herramientas y respuestas que puede leer otro programa
La llamada a funciones permite conectar el modelo con herramientas externas. El programa le presenta las funciones disponibles, el modelo devuelve cuál quiere utilizar y con qué argumentos, y la aplicación ejecuta la operación. Después envía el resultado al modelo para que continúe la tarea.
Ese reparto explica qué significa la capacidad para trabajar como agente. El acceso a una base de datos o a un sistema empresarial depende de las herramientas y permisos que configure la aplicación. La mera presencia del modelo no le concede acceso a esos recursos.
También admite salidas estructuradas. El modo JSON Object busca devolver un documento JSON válido, mientras que JSON Schema permite exigir una estructura concreta, con campos y tipos definidos. La diferencia resulta útil al extraer información que otro programa debe procesar sin interpretar una respuesta en lenguaje natural.
Análisis visual y compatibilidad de interfaces
La comprensión de imágenes y vídeo permite plantear tareas con capturas de pantalla o documentos visuales junto a instrucciones escritas. La documentación general de visión de QwenCloud describe entradas mediante enlaces o imágenes codificadas, combinadas con texto dentro del mensaje.
Entre los usos descritos están la extracción de texto, las preguntas sobre imágenes y la generación de código a partir de diseños. Son funciones de análisis visual y de producción de respuestas; no deben confundirse con generar imágenes o vídeos.
QwenCloud declara compatibilidad con las interfaces Chat Completions y Responses de OpenAI y Messages de Anthropic. Esa compatibilidad facilita conectar clientes que emplean esos protocolos, aunque las opciones particulares del modelo y las condiciones de Token Plan siguen requiriendo una configuración propia.
Hay otro ajuste para quienes reutilizan clientes anteriores: en este modelo, el límite definido con max_tokens incluye razonamiento y respuesta final, igual que max_completion_tokens. Conservar un valor pensado únicamente para el texto visible puede dejar una respuesta incompleta si buena parte del presupuesto se emplea antes en razonar. La documentación precisa que los modelos Qwen anteriores mantienen su comportamiento.
La documentación sitúa el final del acceso a las 24:00 del 25 de noviembre en UTC+8, equivalentes a las 17:00 de ese día en la España peninsular. QwenCloud indica que el modelo de inteligencia artificial será retirado después de la prueba.
Fin del Artículo. ¡Cuéntanos algo en los Comentarios!